Un modelo frontera coordina, los baratos ejecutan
Notas de campo sobre una pipeline de agentes construida sobre Orca: dónde termina el control plane, qué políticas aporta la capa propia y por qué un Delivery sin ack parecía una notificación perdida.
Durante cuatro días trabajé con un modelo frontera como coordinador y modelos baratos como ejecutores. Cerraron seis épicas en dos proyectos reales, más de cuarenta tareas, y la suite pasó de unos 1.100 tests a casi 2.000. El agente mostraba un coste estimado de $0,01 a $0,13 por tarea.
Orca conserva la ejecución y su estado duradero: es el control plane. Mi pipeline añade las políticas del proyecto. Decide qué puede tocar cada agente, qué pruebas debe superar y cuándo puedo aceptar, reintentar o cerrar su trabajo.
Dos subagentes terminaron casi a la vez. El coordinador atendió al primero y el aviso
del segundo pareció desaparecer. Encontré un Delivery FIFO antiguo sin ack: Orca
seguía entregando ese lote y los avisos posteriores esperaban detrás. Los mensajes
seguían en el buzón. Para recibirlos había que confirmar el lote pendiente.
1. Qué resuelve Orca y qué añade la pipeline
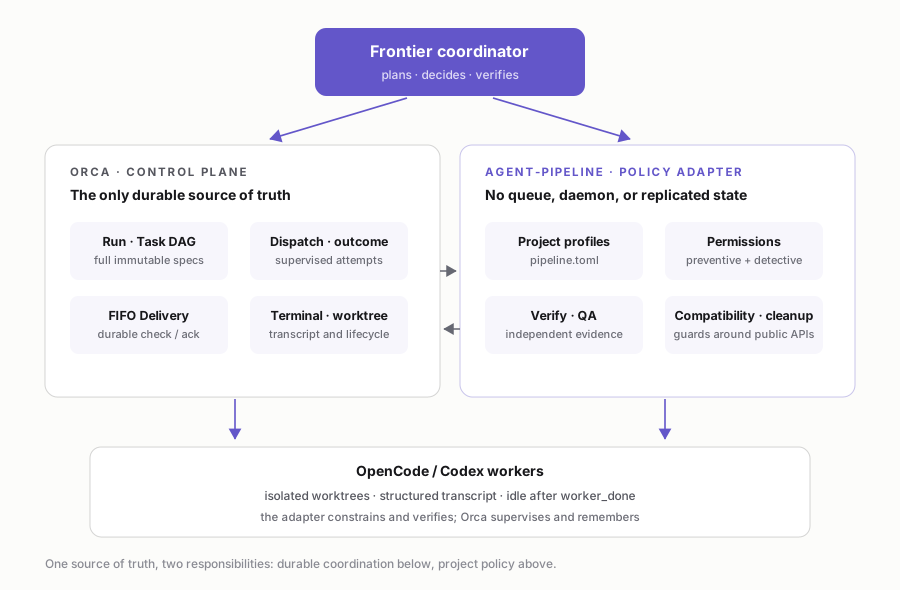
Orca crea Runs, representa un DAG, despacha una Task y mantiene threads duraderos. También supervisa terminales y crea worktrees. Si vuelvo a implementar esas piezas, tengo que sincronizar dos registros de la misma ejecución: el Dispatch de Orca puede contradecir el fichero de una guardia o el PID de un watcher.
Por eso limito mi capa a decisiones que pueda comprobar:
| Orca, control plane | Pipeline, policy adapter |
|---|---|
| Run, DAG, Task y Dispatch | perfil de proyecto y límite de concurrencia |
| Delivery FIFO y threads | resolución completa antes del ack |
| terminal y transcript | comando seguro del agente y confirmación de arranque |
| worktree y ciclo de vida | setup, raíces editables y cleanup seguro |
| outcome del worker | gates, QA y política de retry |
Con ese reparto he podido quitar mucho código. La pipeline no tiene daemon, broker, SQLite, spool NDJSON ni cola local. Solo mantengo un wrapper de Orca cuando impone o verifica una política.
2. Worktrees, contratos y verificación
Cada worker tiene un worktree con checkout, rama y terminal propios. No comparte índice, cachés de build ni servidor de desarrollo. Si falla el proveedor, puedo reemplazar el proceso y conservar en disco el trabajo de la sesión.
Escribo el contrato entero en la Task de Orca: objetivo, alcance, criterios, rutas, casos
y gates. Mantener una copia en .pipeline/specs/ o despachar una frase que apunte a un
fichero externo dejaría artefactos huérfanos y specs ausentes tras una recuperación.
La Task contiene la única copia, y su spec es inmutable en Orca.
OpenCode arranca con permisos cerrados por defecto, una capa del stack y una overlay del
perfil. Un worker de web no puede tocar Electron; uno de seguridad puede editar dos
directorios; uno de QA solo escribe evidencia. Ninguna capa posterior puede volver a
permitir acceso a secretos, claves, .git/** o .pipeline/**.
Antes de aceptar el trabajo, el coordinador vuelve a ejecutar los gates y revisa el diff, aunque el worker haya dicho «todo verde». En Lawyer, el perfil de una tarea que crea rutas añade build y el verificador de bundle. En BIA, tocar estilos globales exige comprobar CSS computado y usar Playwright. Allí typecheck, lint y unit tests pasaron dos veces con la aplicación visualmente rota.
Elijo los gates según lo que el cambio pueda romper.
3. Cómo procesar un Delivery completo
En el mailbox público de Orca, check devuelve el Delivery FIFO más antiguo. Un Delivery
puede contener muchos mensajes. Orca repite el mismo lote hasta que el coordinador lo
confirma entero con su deliveryId.
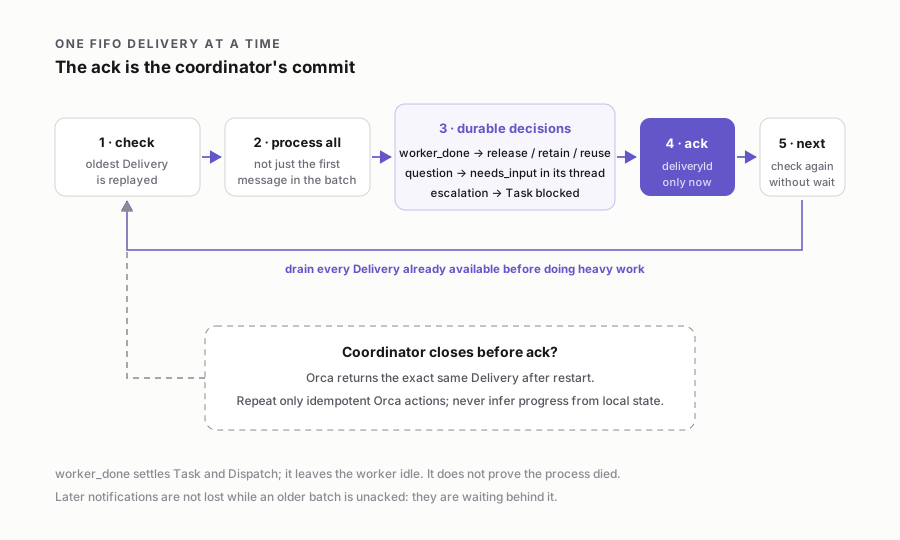
El coordinador sigue estos pasos:
- Obtener el Delivery más antiguo.
- Procesar todos sus mensajes.
- Para cada
worker_done, validar Task, Dispatch y outcome; después reutilizar, retener o liberar el terminal. - Dejar una pregunta como
needs_inputen su thread; bloquear la Task ante una escalation. - Hacer
acksolo cuando cada decisión ya sea duradera en Orca. - Volver a comprobar sin espera hasta vaciar lo ya disponible.
Si el coordinador se cierra entre los pasos 3 y 5, Orca entrega el mismo lote al volver.
Por eso las acciones deben ser idempotentes: worker-release lo es, marcar una Task como
bloqueada lo es y una reutilización comprueba antes si la nueva Task ya tiene Dispatch.
worker_done completa Task y Dispatch, y deja el worker idle con el proceso vivo.
Mandarle un mensaje al Dispatch completado no crea un segundo intento. El coordinador
debe reutilizar explícitamente el terminal con otra Task, retenerlo para depurar o
liberarlo.
4. Compatibilidad de versiones y notificaciones
La versión 1.4.182 de Orca incluye el aviso básico al coordinador de
worker_done (#12988). Lo que todavía no
incluye es el retry que cubre carreras, reinicios y waiters obsoletos
(#14332), fusionado después de la
release 1.4.182.
Trato esa versión como degradada. Aunque el perfil declare tres workers, el límite efectivo es uno. Para forzar el paralelismo hay que indicarlo explícitamente en cada Run, y esa decisión queda visible en el receipt. Mantengo el buzón de Orca.
La pipeline lleva una tabla exacta de compatibilidad. Para añadir la primera release que
incluya #14332, tengo que verificarla y superar un smoke real: dos workers terminan casi
a la vez y el coordinador no mira mientras trabajan. Después compruebo Delivery,
replay, ack y cleanup. Una versión posterior necesita pasar esa comprobación.
Un terminal coordinador mantiene un Run supervisado. Si quieres dos Runs simultáneos, necesitas dos coordinadores. Eso evita waiters que compiten por el mismo buzón.
5. Cómo evitar la carrera de lanzamiento
El atajo de crear worktree, arrancar agente e inyectar la tarea en una sola llamada puede despachar antes de que un agente nuevo esté listo. La carrera sigue documentada en la issue #13488.
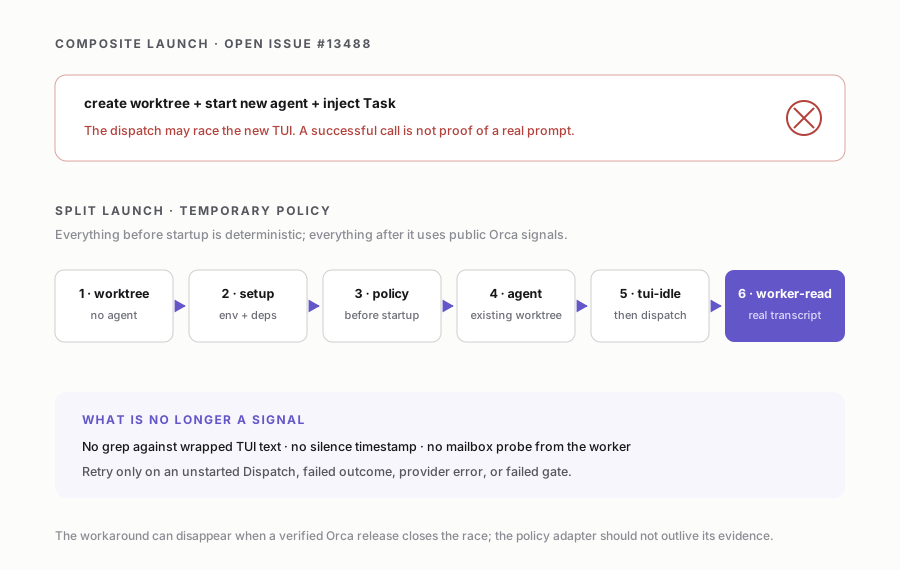
Hasta tener una release verificada, separo el lanzamiento en estos pasos:
- Crear el worktree sin agente.
- Ejecutar setup.
- Escribir la política de OpenCode.
- Lanzar el agente.
- Esperar
tui-idley despachar sobre ese terminal existente. - Confirmar un transcript real con
worker-read.
Leer la pantalla con grep, medir timestamps de silencio o enviar sondas al buzón puede
confundir estados legítimos con fallos. La pipeline reintenta cuando observa un dispatch
no iniciado, un outcome fallido, un error de proveedor o un gate fallido. Un worker puede
estar trabajando aunque no produzca salida.
6. Permisos en OpenCode y Codex
OpenCode puede prevenir escrituras por ruta. Su política se compone como base + stack + overlay y se valida antes de arrancar. Una sustitución puede estrechar el mapa de edición, pero no borrar prohibiciones no negociables.
Codex tiene otra granularidad. Arranca con workspace-write, red desactivada y approvals
desactivados, siguiendo su
configuración oficial. Eso limita
el proceso al workspace, pero no equivale a permitir solo dos carpetas dentro del repo.
La garantía adicional es detectiva: antes de aceptar el resultado, la pipeline compara
todo el diff (commits, staged, unstaged y untracked) con las raíces del perfil.
En OpenCode puedo impedir una escritura; en Codex, ese gate detecta después los cambios fuera de las raíces permitidas. Ambos pueden rechazar el resultado, con distinta exposición durante la ejecución.
7. Cuándo recuperar un worker
Relanzar un worker tras 210 segundos sin salida exigiría leer y clasificar su pantalla. Ese criterio produce falsos positivos cuando un turno dura mucho, la TUI parte palabras o el coordinador está ocupado.
La política de recuperación empieza por estados que Orca sí conoce:
- un Dispatch no arrancó;
- el outcome es
failedo el proveedor devolvió error; - un gate independiente falló;
- una Task quedó bloqueada por una escalation.
Tras fallos repetidos, primero divido la Task y relanzo una sesión limpia en el mismo worktree. Conservo el código aunque la sesión se haya roto. Solo después escalo el modelo: pagar uno más caro deja pendiente el problema si la tarea está mal dividida.
Para cerrar, ejecuto primero worker-release, que archiva el output y libera el terminal
exacto, y luego worktree rm. El borrado se niega si hay cambios sin guardar. Los errores
quedan visibles y todo el cierre pasa por Orca, sin recurrir directamente a Git.
8. QA: estructura, píxeles y evidencia
Un ejecutor sin visión puede recorrer el árbol de accesibilidad, comprobar texto y estructura y producir capturas. Para juzgar peso visual, contraste o fidelidad, necesita que el coordinador o el humano revise esas imágenes.
Pido al worker que enumere lo que no pudo juzgar. En una tanda comprobó correctamente que una cuadrícula tenía cinco celdas y avisó de que no podía saber si las pistas vacías parecían pintadas. Al revisar la captura encontramos ese defecto.
También compruebo los archivos de evidencia. Una captura puede pesar cientos de
kilobytes y estar corrupta. Encontré PNG cuya firma empezaba por efbfbd50 en vez de
89504e47, así que añadí la firma como gate.
9. Coste y tiempo de trabajo
Estas cifras corresponden a lo que observé entre el 8 y el 11 de agosto de 2026. El coste es el que mostraba el ejecutor; los precios del proveedor pueden ser otros.
| Métrica | Observado |
|---|---|
| Épicas cerradas | 6 |
| Tasks procesadas | ~40 |
| Tests | ~1.100 → ~1.950, verdes |
| Coste estimado mostrado por el ejecutor | $0,01–$0,13 por Task |
| Suscripción que pagaba entonces | $10/mes; las llamadas aparecían como $0,00 |
| Presupuesto de tiempo por Task | 45 minutos |
El coste de tokens fue pequeño. Me costaron más las specs ambiguas, los gates que no cubrían la superficie y los Deliveries mal confirmados. También perdí veinte minutos mirando el indicador equivocado.
Mantengo pequeña la pipeline limitándola a decisiones del proyecto que Orca no conoce: qué puede tocar una Task y qué evidencia necesito para aceptarla. Orca conserva Runs, mensajes, Tasks y Dispatches. Cuando algo falla, necesito saber quién lo resuelve y poder recuperar el trabajo desde el estado duradero de Orca.